
Was llms.txt ist – und woher sie kommt
Eine llms.txt ist eine Textdatei, die ganz oben auf einer Domain liegt, unter eure-domain.ch/llms.txt. Sie fasst die Website in wenigen Zeilen zusammen und verlinkt die Seiten, die für ein Sprachmodell zählen. Sprachmodelle, englisch Large Language Models, sind die Programme hinter ChatGPT, Gemini oder Claude.
Vorgeschlagen hat die Datei Jeremy Howard von Answer.AI am 3. September 2024. Seine Begründung steht auf llmstxt.org. Websites richten sich an Menschen, und eine Seite verpackt ihre Information in Navigation, Werbung und Skripte. Das Kontextfenster, also die Textmenge, die ein Modell auf einmal verarbeiten kann, bleibt für die meisten Websites zu klein.
Das Format ist Markdown, also Text mit wenigen Zeichen für Überschriften und Listen. Pflicht ist nur eine Überschrift mit dem Namen der Website. Üblich sind danach ein Satz Zusammenfassung und Linklisten, oft mit einer kurzen Beschreibung pro Link.
Die llms.txt ist ein Vorschlag von 2024 für eine Zusammenfassung eurer Website, geschrieben für Maschinen. Ein verbindlicher Standard ist sie nicht. Sie ersetzt weder die robots.txt, die Crawlern den Zugang steuert, noch die Sitemap, die Seiten für Suchmaschinen auflistet.
Wer llms.txt heute veröffentlicht und wer sie abruft
Zu den Anbietern mit eigener llms.txt gehören Anthropic, Stripe, Cloudflare und Vercel. OpenAI verlinkt auf seiner Seite zu den eigenen Crawlern den Index seiner Dokumentation als llms.txt. Ein Crawler ist ein Programm, das Websites automatisch ausliest.
Ob Programme die Datei auch abrufen, zeigt die Auswertung des SEO-Anbieters Ahrefs. Unter den KI-Werkzeugen liegen GPTBot von OpenAI und der Programmier-Assistent Claude Code vorn, vor allen KI-Suchen und Chat-Assistenten. GPTBot sammelt dabei Trainingsdaten. Das belegt Abrufe, aber keine Nutzung in Antworten. KI-Agenten, also Programme, die selbstständig Aufgaben erledigen, rufen die Datei laut Ahrefs nur ab, wenn man sie darauf hinweist. Auf Verdacht suchen sie nicht danach. Ohne Link, Index oder Anweisung bleibt die Datei meist ungelesen.
Google äussert sich für die Suche eindeutig. In der Anleitung zu KI-Funktionen der Google-Suche steht, die Suche ignoriere llms.txt-Dateien. Sie anzulegen sei trotzdem völlig in Ordnung. Lighthouse, das Prüfwerkzeug von Chrome, behandelt die Datei als freiwillig. Dass ihre Dienste die Datei auslesen, steht in der Crawler-Dokumentation von OpenAI und Anthropic nirgends. Beide Seiten behandeln die robots.txt.
Die wichtigsten Aussagen auf einen Blick:
| Was sie festhält | Stand der Quelle | |
|---|---|---|
| Google Search Central | Die Google-Suche ignoriert llms.txt-Dateien. Sie helfen der Sichtbarkeit nicht und schaden ihr nicht. | Juli 2026 |
| Chrome Lighthouse | Behandelt llms.txt als freiwillig. Fehlt die Datei, gilt der Test als nicht anwendbar. | Mai 2026 |
| Ahrefs, 137'210 Websites | 28 Prozent haben eine Datei, wobei Ahrefs das selbst eine Obergrenze nennt. 97 Prozent dieser Dateien blieben im Mai 2026 ohne einen einzigen Zugriff. | Juni 2026 |
| SE Ranking, rund 300'000 Domains | 10.13 Prozent haben eine Datei. Ein Zusammenhang mit KI-Zitaten zeigt sich laut SE Ranking nicht. | November 2025 |
| Common Crawl, 584'107 Dateien | 68.27 Prozent stammen aus Vorlagen, 22.56 Prozent enthalten keinen einzigen Link. | August 2026 |
Quellen: Google Search Central, Chrome for Developers, Ahrefs, SE Ranking, Common Crawl.
Die Studien messen Verschiedenes. Ahrefs und SE Ranking zählen Abrufe und Zitate, das gemeinnützige Webarchiv Common Crawl liest die Dateien selbst. Drei Einschränkungen gehören zu den Zahlen. Keine der Studien sagt, was ein Anbieter intern mit der Datei tut. Die Quoten von 28 und 10.13 Prozent stammen aus verschiedenen Stichproben und Zeiträumen. Und Ahrefs nennt seine 28 Prozent selbst eine Obergrenze, weil die eigenen Kunden technischer arbeiten als der Durchschnitt.
Die Studien im Original: Ahrefs, SE Ranking und Common Crawl.
Was llms.txt für eine KMU-Website bedeutet
Für die Google-Suche ist die Datei wirkungslos, das sagt Google selbst. Für Antworten von ChatGPT und Co. gibt es bisher keinen belastbaren Beleg, dass sie Zitate bringt. Sie anzulegen kostet wenig Zeit, und der Google-Suche schadet sie nicht. Aufwand und Risiko liegen in der Pflege.
Eine vernünftige Faustregel lautet, die Datei dort anzulegen, wo viel Sachinformation zusammenkommt, etwa bei Preislisten, Produktdaten, Handbüchern oder einer Wissenssammlung. Wird ein Programm auf die Datei hingewiesen, dürfte es mit einer kurzen Übersicht schneller die richtige Seite finden. So begründet es auch llmstxt.org. Bei einer Website mit zehn Seiten bleibt der Nutzen klein.
Ahrefs warnt, eine veraltete Datei führe jeden Agenten in die Irre, der sie liest. Wird die Datei gelesen, schaden alte Preise oder eine frühere Telefonnummer mehr als eine fehlende Datei. Plant die Pflege wie beim Impressum bei jeder Änderung ein.
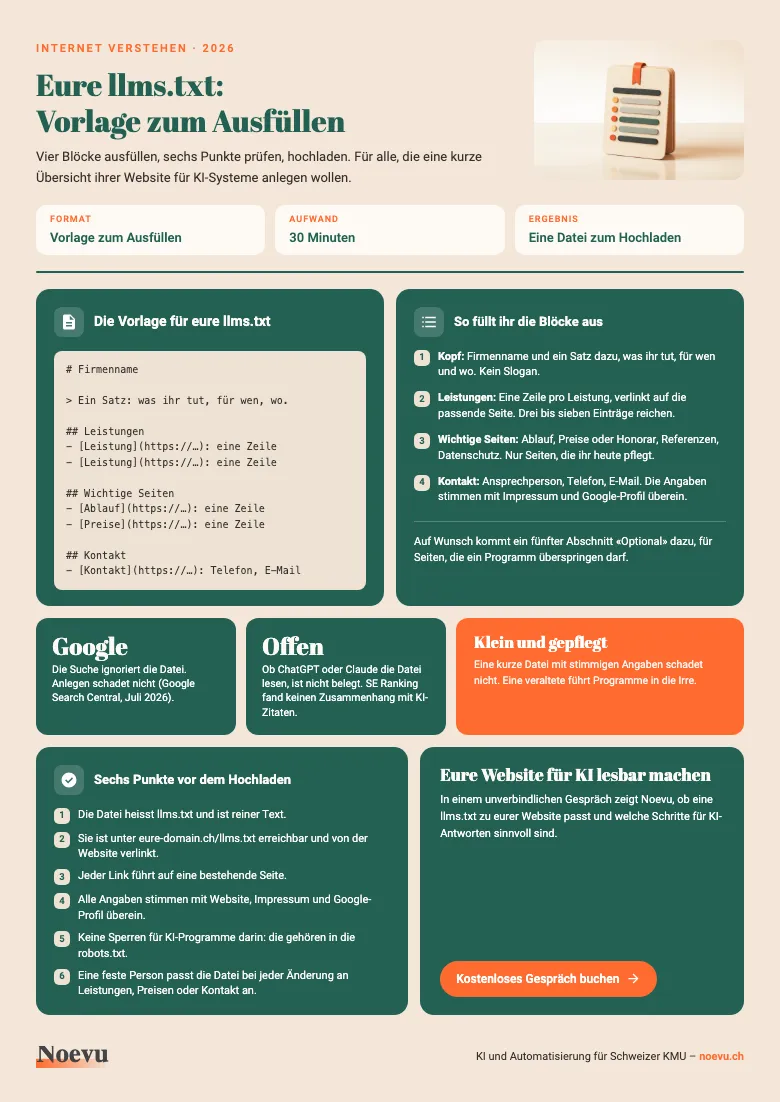
Vorlage: llms.txt für eure Firma
Die Vorlage führt in vier Blöcken zur eigenen llms.txt. Mit Ausfüllhilfe und sechs Prüfpunkten steht die Datei in rund 30 Minuten.
Vielen Dank. Der Download startet gleich.
So legt ihr eine llms.txt an
Für den Einstieg genügt eine kurze Datei: Name, ein Satz und die Seiten, die Besucher zuerst brauchen. Die Datei von noevu.ch umfasst 245 Zeilen und führt auch Leistungen, Referenzen und Hinweise für Sprachmodelle auf. Hier der Anfang der Datei, gekürzt und auf Englisch geschrieben:
# Noevu GmbH

> Swiss web agency born in Zürich, building custom websites, modern content platforms, and AI solutions for Swiss SMEs.

## Key Pages

- [Homepage](https://noevu.ch/de/)
- [About the agency](https://noevu.ch/de/ueber-uns)
- [Tips & Insights (blog)](https://noevu.ch/de/tipps/)
- [Contact](https://noevu.ch/de/kontakt)
Aufbau und Linklisten folgen dem Vorschlag von llmstxt.org, wo eine Beschreibung hinter dem Link optional ist. Wer die Datei selbst anlegt, geht in sechs Schritten vor:
- 1. Namen und Zusammenfassung schreiben Eine Überschrift mit dem Firmennamen, darunter ein Satz dazu, was ihr tut und für wen.
- 2. Wichtige Seiten auswählen Leistungen, Ablauf, Kontakt und Datenschutz reichen für den Anfang. Jeder Link kann eine Zeile Beschreibung bekommen.
- 3. Als Textdatei speichern Dateiname llms.txt, reiner Text. Word und Pages eignen sich nicht, ein einfacher Texteditor genügt.
- 4. Unter /llms.txt ablegen Die Datei muss direkt unter eure-domain.ch/llms.txt erreichbar sein. Plugins wie Yoast SEO erzeugen sie auf Knopfdruck, die Auswahl der Seiten prüft ihr danach selbst. Bei anderen Systemen klärt die Anleitung des Anbieters, wie ihr eine Datei im Hauptverzeichnis hinterlegt.
- 5. Verlinken und im Browser prüfen Ein Link auf der Website macht die Datei auffindbar, noevu.ch setzt ihn in die Fusszeile. Öffnet dann die Adresse und kontrolliert, ob der Text erscheint und jeder Link auf eine bestehende Seite führt.
- 6. Pflege einplanen Bei jeder Änderung an Leistungen, Preisen oder Kontaktdaten wandert die Anpassung in die Datei.
Was ihr neben der llms.txt prüfen könnt
Die Steuerung der KI-Crawler läuft über eine andere Datei, die robots.txt. Sie sagt Crawlern, welche Bereiche einer Website sie auslesen dürfen. OpenAI unterscheidet drei Zugriffe. OAI-SearchBot gehört zur Suche in ChatGPT, GPTBot zum Training von Modellen und ChatGPT-User zu Aktionen, die Nutzer selbst auslösen. OpenAI empfiehlt, den OAI-SearchBot zuzulassen, wenn eure Seiten in den Suchantworten von ChatGPT erscheinen sollen. Anthropic schreibt, dass seine Programme Sperren in der robots.txt befolgen.
Wer die Crawler der grossen KI-Anbieter fernhalten will, trägt das in die robots.txt ein. Bei ChatGPT-User, das im Auftrag einzelner Nutzer abruft, können robots.txt-Regeln laut OpenAI ins Leere laufen. In der llms.txt bleibt ein solcher Eintrag wirkungslos. Common Crawl hat 584'107 Dateien ausgewertet und hält fest, dass eine Sperre dort nichts sperrt.
Für die Google-Suche schreibt Google, dass es keine neuen maschinenlesbaren Dateien, kein besonderes Markup und kein Markdown braucht. Die llms.txt führt die Anleitung ausdrücklich unter den Massnahmen auf, die ihr euch sparen könnt. Google verweist stattdessen auf wirksame SEO-Arbeit.
Unabhängig von der llms.txt lohnt ein Blick auf gut lesbare Seiten und den Aufbau im HTML-Quelltext. Strukturierte Daten braucht Google dafür nicht. Sie benennen eure Firmendaten für Maschinen eindeutig, ob KI-Antworten davon profitieren, ist nicht belegt. Wie oft eure Domain in KI-Antworten tatsächlich auftaucht, könnt ihr stichprobenartig prüfen. Die Seite zu KI-Sichtbarkeit für Schweizer KMU zeigt, wie das abläuft. Ob eine llms.txt zu eurer Website passt, entscheidet meist die Faustregel oben. Für Zweifelsfälle hilft ein Gespräch zu KI-Sichtbarkeit.
Ein kurzes Gespräch zeigt, ob und wie eure Website in KI-Antworten auftaucht und welche Schritte für euch sinnvoll sind. Eine llms.txt gehört nicht zwingend dazu.
Häufig gestellte Fragen
Was ist eine llms.txt?
Eine llms.txt ist eine Textdatei unter eure-domain.ch/llms.txt. Sie fasst eure Website in Markdown zusammen und verlinkt die wichtigsten Seiten, meist mit einer kurzen Beschreibung. Vorgeschlagen hat sie Jeremy Howard von Answer.AI im September 2024, ein verbindlicher Internetstandard ist sie aber nicht. Pflicht ist nur eine Überschrift mit dem Namen der Website.
Liest Google die llms.txt?
Die Google-Suche nicht, schreibt Google. In der Anleitung zu KI-Funktionen steht, die Suche ignoriere solche Dateien. Die Datei verbessert das Ranking also nicht und schadet ihm nicht. Chrome prüft sie in Lighthouse als freiwilligen Test. Fehlt die Datei, gilt er als nicht anwendbar.
Lesen ChatGPT und Claude die llms.txt?
Einen Beleg gibt es nicht. In der Crawler-Dokumentation von OpenAI und Anthropic steht nirgends, dass die Dienste die Datei auslesen. Ahrefs sieht Abrufe durch GPTBot und den Programmier-Assistenten Claude Code, das belegt aber keine Nutzung in Antworten. SE Ranking fand keinen Zusammenhang zwischen der Datei und Zitaten in KI-Antworten.
Was unterscheidet llms.txt, robots.txt und sitemap.xml?
Die robots.txt sagt Programmen, welche Bereiche sie auslesen dürfen. Die sitemap.xml listet alle Seiten für Suchmaschinen auf. Die llms.txt wählt wenige wichtige Seiten aus und beschreibt sie in Textform. Viele Crawler befolgen die robots.txt freiwillig, und sie ist der etablierte Weg, Zugriffe zu steuern. Bei der llms.txt gibt es laut Common Crawl keine Pflicht, sie zu lesen.
Kann man mit der llms.txt KI-Programme aussperren?
Nein, dafür gibt es die robots.txt. Common Crawl hat 584'107 llms.txt-Dateien ausgewertet und festgestellt, dass Sperren dort nichts bewirken. Wer GPTBot oder ClaudeBot fernhalten will, trägt das in die robots.txt ein.
Wo gehört die llms.txt hin, und wie oft braucht sie Pflege?
Die Datei muss direkt unter eure-domain.ch/llms.txt erreichbar sein. Plugins wie Yoast SEO können sie auf Knopfdruck erzeugen, bei anderen Systemen hilft die Anleitung des Anbieters. Pflegt sie bei jeder inhaltlichen Änderung. Eine veraltete Datei führt Programme in die Irre.