
O que é o llms.txt – e de onde ele vem
Um llms.txt é um arquivo de texto que fica na raiz de um domínio, em seu-dominio.com/llms.txt. Ele resume o site em poucas linhas e aponta as páginas que importam para um modelo de linguagem. Modelos de linguagem, em inglês large language models, são os programas por trás do ChatGPT, do Gemini ou do Claude.
Quem propôs o arquivo foi Jeremy Howard, da Answer.AI, em 3 de setembro de 2024. A justificativa dele está em llmstxt.org. Sites são feitos para pessoas, e uma página embala a sua informação em navegação, anúncios e scripts. A janela de contexto, ou seja, a quantidade de texto que um modelo consegue processar de uma vez, continua pequena demais para a maioria dos sites.
O formato é Markdown, isto é, texto com poucos caracteres para títulos e listas. O único requisito é um título com o nome do site. Costumam vir depois uma frase de resumo e listas de links, muitas vezes com uma breve descrição por link.
O llms.txt é uma proposta de 2024 para um resumo do seu site, escrito para máquinas. Ele não é um padrão obrigatório. Não substitui o robots.txt, que controla o acesso dos rastreadores, nem o sitemap, que lista páginas para os mecanismos de busca.
Quem publica o llms.txt hoje e quem o consulta
Entre os fornecedores com llms.txt próprio estão Anthropic, Stripe, Cloudflare e Vercel. Na página sobre os próprios rastreadores, a OpenAI aponta o índice da sua documentação como llms.txt. Um rastreador é um programa que lê sites automaticamente.
Se os programas também consultam o arquivo, mostra a análise do fornecedor de SEO Ahrefs. Entre as ferramentas de IA, o GPTBot da OpenAI e o assistente de programação Claude Code aparecem na frente, à frente de todas as buscas por IA e assistentes de chat. O GPTBot coleta dados de treinamento nesse processo. Isso comprova acessos, mas não uso em respostas. Segundo a Ahrefs, agentes de IA, isto é, programas que executam tarefas por conta própria, só consultam o arquivo quando alguém os orienta a fazê-lo. Eles não o procuram por precaução. Sem link, índice ou instrução, o arquivo costuma ficar sem leitura.
Sobre a busca, o Google é inequívoco. No guia sobre os recursos de IA da busca do Google consta que a busca ignora arquivos llms.txt. O Google acrescenta que criá-lo continua sendo perfeitamente aceitável. O Lighthouse, a ferramenta de auditoria do Chrome, trata o arquivo como opcional. Que os serviços da OpenAI e da Anthropic leiam o arquivo não consta em lugar nenhum da documentação dos rastreadores. As duas páginas tratam do robots.txt.
As afirmações principais num relance:
| O que registra | Data da fonte | |
|---|---|---|
| Google Search Central | A busca do Google ignora arquivos llms.txt. Eles não ajudam a visibilidade e não a prejudicam. | julho de 2026 |
| Chrome Lighthouse | Trata o llms.txt como opcional. Se o arquivo não existe, o teste é considerado não aplicável. | maio de 2026 |
| Ahrefs, 137.210 sites | 28% têm um arquivo, número que a própria Ahrefs chama de limite superior. 97% desses arquivos ficaram sem um único acesso em maio de 2026. | junho de 2026 |
| SE Ranking, cerca de 300.000 domínios | 10,13% têm um arquivo. Segundo a SE Ranking, não há relação com citações de IA. | novembro de 2025 |
| Common Crawl, 584.107 arquivos | 68,27% vêm de modelos prontos, 22,56% não contêm um único link. | agosto de 2026 |
Fontes: Google Search Central, Chrome for Developers, Ahrefs, SE Ranking, Common Crawl.
Os estudos medem coisas diferentes. Ahrefs e SE Ranking contam acessos e citações, enquanto o Common Crawl, um arquivo da web sem fins lucrativos, lê os próprios arquivos. Três ressalvas acompanham os números. Nenhum dos estudos diz o que um fornecedor faz internamente com o arquivo. As taxas de 28% e 10,13% vêm de amostras e períodos diferentes. E a própria Ahrefs chama os seus 28% de limite superior, porque os clientes dela trabalham de forma mais técnica do que a média.
Os estudos no original: Ahrefs, SE Ranking e Common Crawl.
O que o llms.txt significa para o site de uma PME
Para a busca do Google, o arquivo não tem efeito, como o próprio Google diz. Para respostas do ChatGPT e companhia, até agora não há comprovação confiável de que ele traga citações. Criá-lo custa pouco tempo e não prejudica a busca do Google. Esforço e risco estão na manutenção.
Uma regra prática sensata é criar o arquivo onde muita informação factual se reúne, como listas de preços, dados de produtos, manuais ou uma base de conhecimento. Se um programa for orientado a consultar o arquivo, uma visão geral curta deve ajudá-lo a achar a página certa mais rápido. É também a justificativa de llmstxt.org. Num site com dez páginas, o benefício continua pequeno.
A Ahrefs alerta que um arquivo desatualizado induz ao erro qualquer agente que o leia. Se o arquivo é lido, preços antigos ou um telefone anterior prejudicam mais do que a falta do arquivo. Planeje a manutenção a cada mudança, como faria com o aviso legal (Impressum).
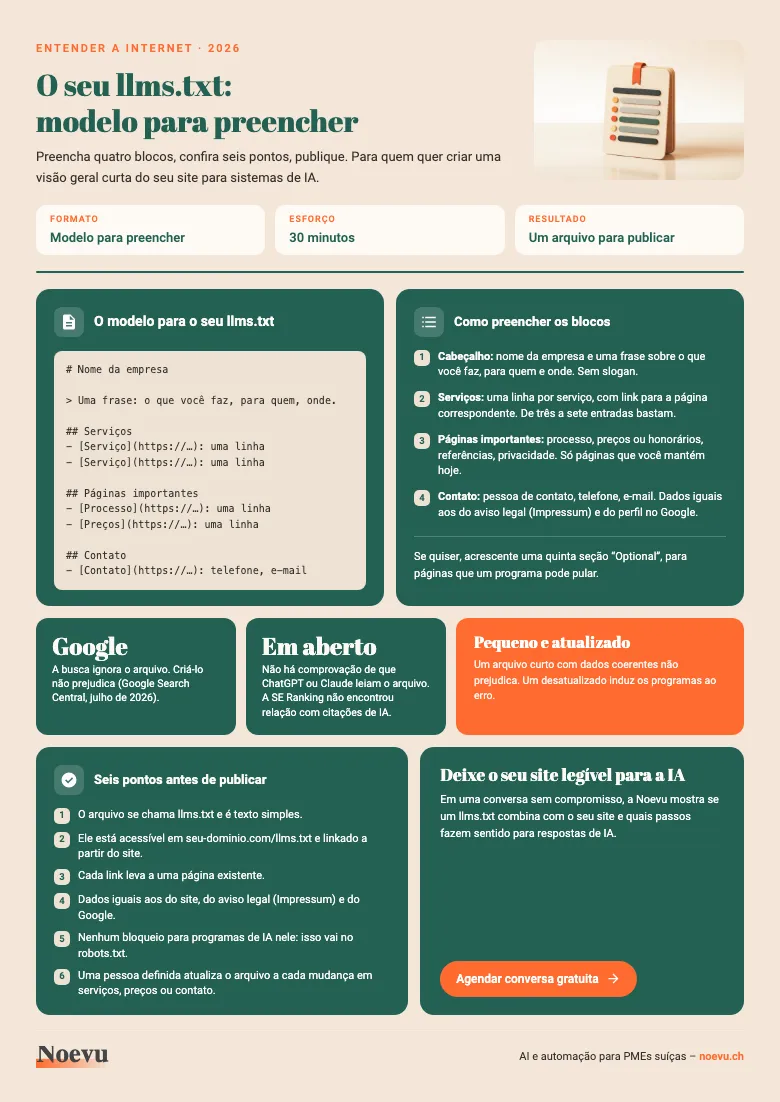
Modelo: llms.txt para a sua empresa
O modelo leva ao seu próprio llms.txt em quatro blocos. Com orientações de preenchimento e seis pontos de verificação, o arquivo fica pronto em cerca de 30 minutos.
Obrigado. O download começará em instantes.
Como criar um llms.txt
Para começar, basta um arquivo curto: nome, uma frase e as páginas de que os visitantes precisam primeiro. O arquivo do noevu.ch tem 245 linhas e lista também serviços, referências e orientações para modelos de linguagem. Aqui está o início do arquivo, resumido. Ele está escrito em inglês:
# Noevu GmbH

> Swiss web agency born in Zürich, building custom websites, modern content platforms, and AI solutions for Swiss SMEs.

## Key Pages

- [Homepage](https://noevu.ch/de/)
- [About the agency](https://noevu.ch/de/ueber-uns)
- [Tips & Insights (blog)](https://noevu.ch/de/tipps/)
- [Contact](https://noevu.ch/de/kontakt)
A estrutura e as listas de links seguem a proposta de llmstxt.org, em que uma descrição depois do link é opcional. Quem cria o arquivo por conta própria segue seis passos:
- 1. Escrever o nome e um resumo Um título com o nome da empresa e, abaixo, uma frase sobre o que você faz e para quem.
- 2. Escolher as páginas importantes Serviços, processo, contato e privacidade bastam para começar. Cada link pode ganhar uma linha de descrição.
- 3. Salvar como arquivo de texto Nome do arquivo llms.txt, texto simples. Word e Pages não servem; um editor de texto simples basta.
- 4. Colocar em /llms.txt O arquivo precisa estar acessível diretamente em seu-dominio.com/llms.txt. Plugins como o Yoast SEO o geram com um clique, e a escolha das páginas você confere depois. Em outros sistemas, o guia do fornecedor esclarece como colocar um arquivo no diretório principal.
- 5. Linkar e conferir no navegador Um link no site torna o arquivo encontrável; o noevu.ch o coloca no rodapé. Depois, abra o endereço e confira se o texto aparece e se cada link leva a uma página existente.
- 6. Planejar a manutenção A cada mudança em serviços, preços ou dados de contato, o ajuste vai para o arquivo.
O que conferir além do llms.txt
O controle dos rastreadores de IA passa por outro arquivo, o robots.txt. Ele diz aos rastreadores quais áreas de um site podem ser lidas. A OpenAI distingue três tipos de acesso. O OAI-SearchBot pertence à busca do ChatGPT, o GPTBot ao treinamento de modelos e o ChatGPT-User a ações que os próprios usuários disparam. A OpenAI recomenda permitir o OAI-SearchBot se as suas páginas devem aparecer nas respostas de busca do ChatGPT. A Anthropic escreve que os seus programas respeitam bloqueios no robots.txt.
Quem quer manter os rastreadores dos grandes fornecedores de IA fora registra isso no robots.txt. No caso do ChatGPT-User, que acessa em nome de usuários individuais, regras do robots.txt podem não surtir efeito, segundo a OpenAI. No llms.txt, uma entrada dessas não tem efeito. O Common Crawl analisou 584.107 arquivos e registra que um bloqueio ali não bloqueia nada.
Para a busca do Google, o Google escreve que não são necessários novos arquivos legíveis por máquinas, nenhum markup especial e nenhum Markdown. O guia lista o llms.txt expressamente entre as medidas que você pode dispensar. O Google aponta, em vez disso, para um trabalho de SEO eficaz.
Independentemente do llms.txt, vale olhar para páginas legíveis e para a estrutura do código-fonte HTML. O Google não precisa de dados estruturados para isso. Eles nomeiam os dados da sua empresa de forma inequívoca para máquinas; se respostas de IA se beneficiam disso, não está comprovado. Com que frequência o seu domínio de fato aparece em respostas de IA, você pode verificar por amostragem. A página sobre visibilidade em IA para PMEs suíças mostra como isso funciona. Se um llms.txt combina com o seu site, a regra prática acima costuma decidir. Para casos de dúvida, ajuda uma conversa sobre visibilidade em IA.
Uma conversa breve mostra se e como o seu site aparece em respostas de IA e quais passos fazem sentido para você. Um llms.txt não faz necessariamente parte deles.
Perguntas Frequentes
O que é um llms.txt?
Um llms.txt é um arquivo de texto em seu-dominio.com/llms.txt. Ele resume o seu site em Markdown e aponta as páginas mais importantes, em geral com uma breve descrição. Quem o propôs foi Jeremy Howard, da Answer.AI, em setembro de 2024, mas ele não é um padrão obrigatório da internet. O único requisito é um título com o nome do site.
O Google lê o llms.txt?
A busca do Google não lê, diz o próprio Google. No guia sobre recursos de IA consta que a busca ignora esses arquivos. Ou seja, o arquivo não melhora o ranking e também não o prejudica. O Chrome o verifica no Lighthouse como um teste opcional. Se o arquivo não existe, o teste é considerado não aplicável.
O ChatGPT e o Claude leem o llms.txt?
Não há comprovação. Na documentação dos rastreadores da OpenAI e da Anthropic não consta em lugar nenhum que os serviços leiam o arquivo. A Ahrefs observa acessos do GPTBot e do assistente de programação Claude Code, mas isso não prova uso em respostas. A SE Ranking não encontrou relação entre o arquivo e citações em respostas de IA.
Qual é a diferença entre llms.txt, robots.txt e sitemap.xml?
O robots.txt diz aos programas quais áreas eles podem ler. O sitemap.xml lista todas as páginas para os mecanismos de busca. O llms.txt seleciona poucas páginas importantes e as descreve em forma de texto. Muitos rastreadores seguem o robots.txt voluntariamente, e ele é o caminho consolidado para controlar acessos. No caso do llms.txt, segundo o Common Crawl, não existe obrigação de lê-lo.
Dá para barrar programas de IA com o llms.txt?
Não, para isso existe o robots.txt. O Common Crawl analisou 584.107 arquivos llms.txt e constatou que bloqueios neles não têm efeito. Quem quer manter o GPTBot ou o ClaudeBot fora registra isso no robots.txt.
Onde fica o llms.txt e com que frequência ele precisa de manutenção?
O arquivo precisa estar acessível diretamente em seu-dominio.com/llms.txt. Plugins como o Yoast SEO o geram com um clique; em outros sistemas, vale o guia do fornecedor. Atualize-o a cada mudança de conteúdo. Um arquivo desatualizado induz os programas ao erro.